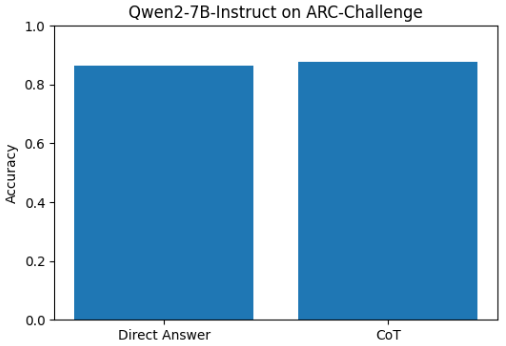
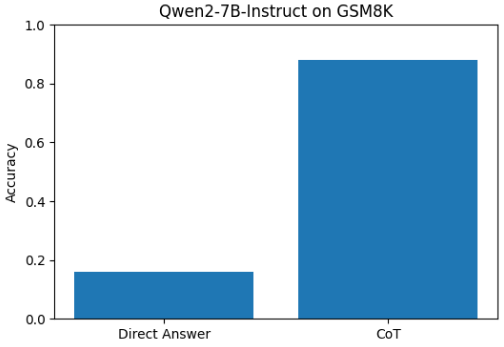
AbstractCoT는 복잡한 문제에서 LLM의 성능을 높이지만, 모델이 출력한 reasoning step이 실제로 final answer에 영향을 주지 않는 경우가 존재한다.기존 연구는 “CoT가 faithful 한가?” 에 집중했지만 “모델 자체를 더 faithful하게 만들려면 어떻게 학습해야 하는가?” 에 대한 scalable한 방법은 상대적으로 부족했다.FRIT 제안논문은 **Faithful Reasoning via Intervention Training (FRIT)**을 제안한다.모델이 생성한 CoT의 reasoning step에 intervention해당 step이 final answer에 실제 영향을 주는지 측정이를 이용해 faithful / unfaithful CoT pair 생성DPO를..