mkdir -p ~/research
cd ~/research

git clone https://github.com/Zayne-sprague/To-CoT-or-not-to-CoT.git
cd To-CoT-or-not-to-CoT
원본 저장소는 Hugging Face 모델을 보통 vLLM 서버로 띄운 뒤 endpoint로 호출하도록 구성돼 있는데, 학교 Gpu 서버 환경에는 vLLM이 없어서 먼저 transformer로 로컬 모델 실행을 확인하고, 그다음 원본 코드에 연결하기로 했고 14개의 모델을 전부 실행하기엔 어려워서 논문에서 사용한 Qwen 2 대신 Qwen 2.5 7B를 대신 사용했음.
Qwen 2.5 7B 불러오기
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

MODEL_NAME = "Qwen/Qwen2-7B-Instruct"

print("tokenizer")

tokenizer = AutoTokenizer.from_pretrained(
    MODEL_NAME,
    use_fast=True,
)

print("model")

try:
    model = AutoModelForCausalLM.from_pretrained(
        MODEL_NAME,
        dtype=torch.bfloat16,
        device_map="auto",
        low_cpu_mem_usage=True,
        attn_implementation="sdpa",
    )
except TypeError:
    model = AutoModelForCausalLM.from_pretrained(
        MODEL_NAME,
        torch_dtype=torch.bfloat16,
        device_map="auto",
        low_cpu_mem_usage=True,
        attn_implementation="sdpa",
    )

model.eval()

print("f modle load")
print("model dtype:", model.dtype)
print("model device:", next(model.parameters()).device)
원 논문은 20개 데이터셋 × 14개 모델에 대해 Zero-shot/Few-shot과 Direct Answer/CoT를 비교했다. 모델 추론에는 vLLM과 greedy decoding을 사용했다. 이 전체 조합을 한 번에 따라 하면 실험량과 코드 수정 범위가 너무 커서 첫 실험에서는 다음만 유지했다.
- 모델 ⇒ Qwen2-7B-Instruct
- 데이터셋 ⇒ GSM8K(수학 추론에서 CoT 효과가 크다는 것이 논문에서의 주장이기 때문에 실험 파이프라인이 정상인지 확인 할 때 가장 명확한 차이를 기대할 수 있을 것이라 생각되어 선택함, 추후에 CommonsenseQA 같은 걸로도 실험을 통해 영역별 차이까지 볼 예정 )
- 조건 A ⇒ Zero-shot Direct Answer
- 조건 B ⇒ Zero-shot CoT
- 디코딩 ⇒ Greedy decoding
- 프롬프트 ⇒ 논문 공식 git의 프롬프트 그대로
- 정답 판정 ⇒ 논문 공식 git의 GSM8K evaluator 그대로
GSM8K 데이터셋 클래스 불러오기
from eval_datasets.types.gsm8k import GSM8KDataset
gsm8k_dataset = GSM8KDataset(
    variant="original",
    use_llama_3_1_prompts=False,
)
print("GSM8K 데이터 개수:", len(gsm8k_dataset))
Greedy 함수 생성
def generate_response(
    messages: list[dict[str, str]],
    max_new_tokens: int = 1024,
) -> str:

    # 마지막 메시지가 assistant이면
    # 새로운 assistant 메시지를 추가하지 않고 기존 문장을 이어서 생성
    has_assistant_prefill = (
        len(messages) > 0
        and messages[-1]["role"] == "assistant"
    )

    if has_assistant_prefill:
        prompt_text = tokenizer.apply_chat_template(
            messages,
            tokenize=False,
            continue_final_message=True,
        )
    else:
        prompt_text = tokenizer.apply_chat_template(
            messages,
            tokenize=False,
            add_generation_prompt=True,
        )

    encoded = tokenizer(
        prompt_text,
        return_tensors="pt",
    )

    device = next(model.parameters()).device

    encoded = {
        key: value.to(device)
        for key, value in encoded.items()
    }

    input_length = encoded["input_ids"].shape[1]

    with torch.inference_mode():
        output_ids = model.generate(
            **encoded,
            max_new_tokens=max_new_tokens,
            do_sample=False,
            eos_token_id=tokenizer.eos_token_id,
            pad_token_id=tokenizer.pad_token_id,
        )

    generated_ids = output_ids[0, input_length:]

    generated_text = tokenizer.decode(
        generated_ids,
        skip_special_tokens=True,
    ).strip()

    # assistant prefill이 있었다면 평가를 위해 원래 prefix도 다시 붙임
    if has_assistant_prefill:
        return (
            messages[-1]["content"] + generated_text
        ).strip()

    return generated_text
저자 코드의 실제 프롬프트 확인
- 데이터 예시의 주요 키
dict_keys(['question', 'answer', 'dataset_type', 'prompt_parts', 'answerKey', 'messages', 'zs_cot_messages', 'zs_cotless_messages', 'fs_cot_messages', 'fs_cotless_messages']) - 문제
Anthony had 50 pencils. He gave 1/2 of his pencils to Brandon, and he gave 3/5 of the remaining pencils to Charlie. He kept the remaining pencils. How many pencils did Anthony keep? - 정답
10 - 공식 Direct Answer 프롬프트
[system]
You are a helpful AI assistant that will answer reasoning questions. You will only say "\boxed{your answer}". You must end your response with $\boxed{your answer}$ everytime! -[user]
Solve the following math problem. Box your final answer: $\boxed{your answer}$.Remember to box your final answer via $\boxed{your answer}$. Problem
Anthony had 50 pencils. He gave 1/2 of his pencils to Brandon, and he gave 3/5 of the remaining pencils to Charlie. He kept the remaining pencils. How many pencils did Anthony keep?
- 공식 CoT 프롬프트
[system]
You are a helpful AI assistant that will answer reasoning questions. You will reason step by step and you will always say at the end $\boxed{your answer}$". You must end your response with "\boxed{your answer}" everytime! - [user]
Solve the following math problem. Explain your reasoning step by step. When you are finished, box your final answer: $\boxed{your answer}$. - Problem:
Anthony had 50 pencils. He gave 1/2 of his pencils to Brandon, and he gave 3/5 of the remaining pencils to Charlie. He kept the remaining pencils. How many pencils did Anthony keep?Remember to box your final answer via $\boxed{your answer}$. ⇒ 위에서 볼 수 있듯 Direct Answer, CoT의 reasoning 지시가 다른 것을 확인 할 수 있다
범용 실험 함수 만들기
from pathlib import Path
from time import perf_counter

import pandas as pd
from tqdm.auto import tqdm


def run_pairwise_experiment(
    dataset,
    dataset_name: str,
    num_samples: int,
    output_csv: str,
    max_new_tokens: int = 1024,
) -> pd.DataFrame:
    """
    같은 문제에 대해
    1. Zero-shot Direct Answer
    2. Zero-shot CoT
    를 실행하고 공식 evaluator로 평가한다.

    중간에 커널이 종료되어도 다시 이어서 실행할 수 있도록
    매 문제마다 CSV를 저장한다.
    """

    output_path = Path(output_csv)
    output_path.parent.mkdir(parents=True, exist_ok=True)

    # 이전 실행 결과가 있으면 불러와 이어서 실행
    if output_path.exists():
        previous_results = pd.read_csv(output_path)
        records = previous_results.to_dict("records")
        completed_indices = set(
            previous_results["index"].astype(int).tolist()
        )

        print(
            f"기존 결과 {len(completed_indices)}개를 불러왔습니다."
        )
    else:
        records = []
        completed_indices = set()

    target_count = min(num_samples, len(dataset))

    for index in tqdm(range(target_count)):

        if index in completed_indices:
            continue

        example = dataset[index]

        question = str(
            example.get(
                "question",
                example.get("question_format", ""),
            )
        )

        gold_answer = str(example.get("answer", ""))

        try:
            # Direct Answer 조건
            direct_start = perf_counter()

            direct_response = generate_response(
                example["zs_cotless_messages"],
                max_new_tokens=max_new_tokens,
            )

            direct_seconds = perf_counter() - direct_start

            direct_metric = dataset.evaluate_response(
                [direct_response],
                example,
            )[0]
            # CoT 조건
            cot_start = perf_counter()

            cot_response = generate_response(
                example["zs_cot_messages"],
                max_new_tokens=max_new_tokens,
            )

            cot_seconds = perf_counter() - cot_start

            cot_metric = dataset.evaluate_response(
                [cot_response],
                example,
            )[0]

            # 실제 출력 토큰 수
            direct_tokens = len(
                tokenizer.encode(
                    direct_response,
                    add_special_tokens=False,
                )
            )

            cot_tokens = len(
                tokenizer.encode(
                    cot_response,
                    add_special_tokens=False,
                )
            )

            record = {
                "dataset": dataset_name,
                "index": index,
                "question": question,
                "gold_answer": gold_answer,

                "direct_model_answer": direct_metric.get(
                    "model_answer"
                ),
                "cot_model_answer": cot_metric.get(
                    "model_answer"
                ),

                "direct_correct": bool(
                    direct_metric.get("correct", False)
                ),
                "cot_correct": bool(
                    cot_metric.get("correct", False)
                ),

                "direct_unparsable": (
                    direct_metric.get("model_answer") is None
                ),
                "cot_unparsable": (
                    cot_metric.get("model_answer") is None
                ),

                "direct_output_tokens": direct_tokens,
                "cot_output_tokens": cot_tokens,

                "direct_seconds": direct_seconds,
                "cot_seconds": cot_seconds,

                "direct_response": direct_response,
                "cot_response": cot_response,

                "error": "",
            }

        except Exception as error:
            record = {
                "dataset": dataset_name,
                "index": index,
                "question": question,
                "gold_answer": gold_answer,

                "direct_model_answer": None,
                "cot_model_answer": None,

                "direct_correct": False,
                "cot_correct": False,

                "direct_unparsable": True,
                "cot_unparsable": True,

                "direct_output_tokens": 0,
                "cot_output_tokens": 0,

                "direct_seconds": 0,
                "cot_seconds": 0,

                "direct_response": "",
                "cot_response": "",

                "error": repr(error),
            }

        records.append(record)

        # 매 문제마다 중간 저장
        pd.DataFrame(records).sort_values(
            "index"
        ).to_csv(
            output_path,
            index=False,
            encoding="utf-8-sig",
        )

    result_df = pd.DataFrame(records).sort_values(
        "index"
    ).reset_index(drop=True)

    return result_df
선행 20문제
OUTPUT_FILE = "results/qwen2_7b_gsm8k_pairwise.csv"

gsm8k_results = run_pairwise_experiment(
    dataset=gsm8k_dataset,
    dataset_name="GSM8K",
    num_samples=20,
    output_csv=OUTPUT_FILE,
    max_new_tokens=1024,
)

gsm8k_results.head()
이를 먼저 실행 하는 이유는 모델생성이 정상적으로 끝나는지, CoT가 단계별로 추론을 생성하는지, Direct answering이 실제로 짧게 끝나는지 등을 파악하기 위함이다.
첫 번째 선행 실험에서는 시간, True/False 판별에서 CoT와 direct respons가 이상하게 나왔다. 아마도 원문에서 greedy 함수를 vLLM 기반으로 사용했던 것과 다르게 transformer 기준으로 바꾸면서 문제가 생긴 듯 해서 greedy 함수를 재정의 했다.
def generate_response(
    messages,
    max_new_tokens,
):
    """
    Qwen 모델로 greedy decoding을 수행한다.

    원 논문의 vLLM 설정:
    - temperature = 0
    - top_p = 1
    - rollout = 1

    Transformers 대응 설정:
    - do_sample = False
    - num_beams = 1
    """

    has_assistant_prefill = (
        len(messages) > 0
        and messages[-1]["role"] == "assistant"
    )

    if has_assistant_prefill:
        # 마지막 assistant 메시지 뒤를 이어서 생성
        prompt_text = tokenizer.apply_chat_template(
            messages,
            tokenize=False,
            continue_final_message=True,
        )

        assistant_prefix = messages[-1]["content"]

    else:
        # 새로운 assistant 답변 시작
        prompt_text = tokenizer.apply_chat_template(
            messages,
            tokenize=False,
            add_generation_prompt=True,
        )

        assistant_prefix = ""

    encoded = tokenizer(
        prompt_text,
        return_tensors="pt",
    )

    device = next(model.parameters()).device

    encoded = {
        key: value.to(device)
        for key, value in encoded.items()
    }

    input_length = encoded["input_ids"].shape[1]

    with torch.inference_mode():
        output_ids = model.generate(
            **encoded,

            max_new_tokens=max_new_tokens,

            # Greedy decoding
            do_sample=False,
            num_beams=1,

            eos_token_id=tokenizer.eos_token_id,
            pad_token_id=tokenizer.pad_token_id,

            use_cache=True,
        )

    # 입력 프롬프트를 제외하고 새로 생성한 부분만 가져옴
    generated_ids = output_ids[0, input_length:]

    continuation = tokenizer.decode(
        generated_ids,
        skip_special_tokens=True,
    ).strip()

    # Direct 조건은 '$\boxed{'가 입력에 포함돼 있었으므로
    # 평가를 위해 다시 앞에 붙여서 전체 응답을 복원
    return (
        assistant_prefix + continuation
    ).strip()
전체 실험 함수 재정의
from pathlib import Path
from time import perf_counter

import pandas as pd
from tqdm.auto import tqdm


def run_pairwise_experiment(
    dataset,
    dataset_name,
    num_samples,
    output_csv,
    direct_max_new_tokens=100,
    cot_max_new_tokens=1024,
):
    """
    동일한 GSM8K 문제에 대해 다음을 비교한다.

    1. Zero-shot Direct Answer
    2. Zero-shot Chain-of-Thought

    각 문제마다:
    - 공식 evaluator 결과
    - 숫자 정규화 보조 평가
    - 출력 토큰 수
    - 생성 시간
    - 전체 응답

    을 CSV에 저장한다.
    """

    output_path = Path(output_csv)
    output_path.parent.mkdir(
        parents=True,
        exist_ok=True,
    )

    # 같은 파일이 있으면 이어서 실행
    if output_path.exists():
        previous_results = pd.read_csv(
            output_path
        )

        records = previous_results.to_dict(
            "records"
        )

        completed_indices = set(
            previous_results["index"]
            .astype(int)
            .tolist()
        )

        print(
            f"기존 결과 "
            f"{len(completed_indices)}개를 불러왔습니다."
        )

    else:
        records = []
        completed_indices = set()

    target_count = min(
        num_samples,
        len(dataset),
    )

    for index in tqdm(range(target_count)):

        if index in completed_indices:
            continue

        example = dataset[index]

        question = str(
            example.get("question", "")
        )

        gold_answer = str(
            example.get("answer", "")
        )

        try:
            # -------------------------
            # 프롬프트 준비
            # -------------------------
            direct_messages = (
                prepare_gsm8k_direct_messages(
                    example
                )
            )

            cot_messages = (
                prepare_gsm8k_cot_messages(
                    example
                )
            )

            # -------------------------
            # Direct Answer 실행
            # -------------------------
            direct_start = perf_counter()

            direct_response = generate_response(
                direct_messages,
                max_new_tokens=(
                    direct_max_new_tokens
                ),
            )

            direct_seconds = (
                perf_counter()
                - direct_start
            )

            direct_metric = (
                dataset.evaluate_response(
                    [direct_response],
                    example,
                )[0]
            )

            # -------------------------
            # CoT 실행
            # -------------------------
            cot_start = perf_counter()

            cot_response = generate_response(
                cot_messages,
                max_new_tokens=(
                    cot_max_new_tokens
                ),
            )

            cot_seconds = (
                perf_counter()
                - cot_start
            )

            cot_metric = (
                dataset.evaluate_response(
                    [cot_response],
                    example,
                )[0]
            )

            # -------------------------
            # 출력 토큰 수
            # -------------------------
            direct_tokens = len(
                tokenizer.encode(
                    direct_response,
                    add_special_tokens=False,
                )
            )

            cot_tokens = len(
                tokenizer.encode(
                    cot_response,
                    add_special_tokens=False,
                )
            )

            # 공식 evaluator가 추출한 답
            direct_model_answer = (
                direct_metric.get(
                    "model_answer"
                )
            )

            cot_model_answer = (
                cot_metric.get(
                    "model_answer"
                )
            )

            # 숫자 정규화 보조 평가
            direct_numeric_correct = (
                numeric_answers_equal(
                    direct_model_answer,
                    gold_answer,
                )
            )

            cot_numeric_correct = (
                numeric_answers_equal(
                    cot_model_answer,
                    gold_answer,
                )
            )

            record = {
                "dataset": dataset_name,
                "index": index,
                "question": question,
                "gold_answer": gold_answer,

                "direct_model_answer": (
                    direct_model_answer
                ),
                "cot_model_answer": (
                    cot_model_answer
                ),

                # 저자 공식 evaluator
                "direct_correct": bool(
                    direct_metric.get(
                        "correct",
                        False,
                    )
                ),
                "cot_correct": bool(
                    cot_metric.get(
                        "correct",
                        False,
                    )
                ),

                # 숫자 기준 보조 evaluator
                "direct_numeric_correct": bool(
                    direct_numeric_correct
                ),
                "cot_numeric_correct": bool(
                    cot_numeric_correct
                ),

                "direct_unparsable": (
                    direct_model_answer is None
                ),
                "cot_unparsable": (
                    cot_model_answer is None
                ),

                "direct_output_tokens": (
                    direct_tokens
                ),
                "cot_output_tokens": (
                    cot_tokens
                ),

                "direct_seconds": (
                    direct_seconds
                ),
                "cot_seconds": (
                    cot_seconds
                ),

                "direct_response": (
                    direct_response
                ),
                "cot_response": (
                    cot_response
                ),

                "error": "",
            }

        except Exception as error:
            record = {
                "dataset": dataset_name,
                "index": index,
                "question": question,
                "gold_answer": gold_answer,

                "direct_model_answer": None,
                "cot_model_answer": None,

                "direct_correct": False,
                "cot_correct": False,

                "direct_numeric_correct": False,
                "cot_numeric_correct": False,

                "direct_unparsable": True,
                "cot_unparsable": True,

                "direct_output_tokens": 0,
                "cot_output_tokens": 0,

                "direct_seconds": 0,
                "cot_seconds": 0,

                "direct_response": "",
                "cot_response": "",

                "error": repr(error),
            }

        records.append(record)

        # 문제 하나가 끝날 때마다 저장
        pd.DataFrame(records).sort_values(
            "index"
        ).to_csv(
            output_path,
            index=False,
            encoding="utf-8-sig",
        )

    return (
        pd.DataFrame(records)
        .sort_values("index")
        .reset_index(drop=True)
    )
문제마다
Direct → Qwen → 최종 답
CoT→ Qwen → 추론 + 최종 답
| 항목 | 값 | |
| 0 | 정상 완료 문제 수 | 20.000000 |
| 1 | Direct 공식 정확도 | 0.100000 |
| 2 | CoT 공식 정확도 | 0.850000 |
| 3 | 공식 CoT-Direct 차이(%p) | 75.000000 |
| 4 | Direct 숫자 정확도 | 0.100000 |
| 5 | CoT 숫자 정확도 | 0.900000 |
| 6 | 숫자 CoT-Direct 차이(%p) | 80.000000 |
| 7 | 둘 다 정답 | 2.000000 |
| 8 | CoT만 정답 | 15.000000 |
| 9 | Direct만 정답 | 0.000000 |
| 10 | 둘 다 오답 | 3.000000 |
| 11 | Direct 답 추출 실패율 | 0.000000 |
| 12 | CoT 답 추출 실패율 | 0.000000 |
| 13 | Direct 평균 출력 토큰 | 7.350000 |
| 14 | CoT 평균 출력 토큰 | 275.700000 |
| 15 | Direct 평균 생성 시간 | 0.114806 |
| 16 | CoT 평균 생성 시간 | 5.348551 |
| 17 | Exact McNemar p-value | 0.000061 |
이전과 다르게 답변 시간, 정답률, 토큰 수 차이 등 거의 정상적으로 작동하는 것을 확인 할 수 있었다.
100문제 확인
gsm8k_results = run_pairwise_experiment(
    dataset=gsm8k_dataset,
    dataset_name="GSM8K",

    # 20개에서 100개로 확대
    num_samples=100,

    output_csv=OUTPUT_FILE,

    direct_max_new_tokens=100,
    cot_max_new_tokens=1024,
)

gsm8k_summary = summarize_pairwise_results(
    gsm8k_results
)

gsm8k_summary
같은 output file을 사용하기 때문에 기존 20문제는 제외하고 이후 80개의 문제를 실행하여 결과를 CSV에 저장했다
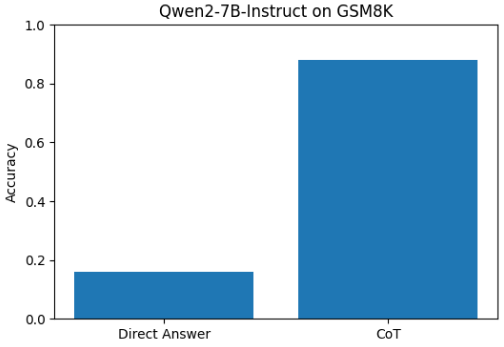
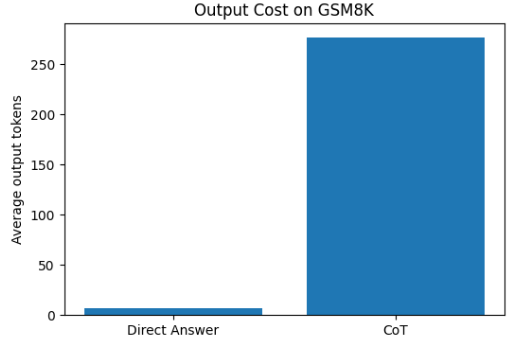
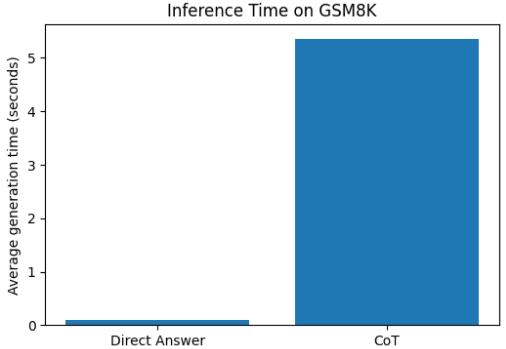
본 축소 실험에서는 Qwen2-7B-Instruct를 대상으로 GSM8K 문제에서 Direct Answer와 Chain-of-Thought(CoT) prompting의 성능을 비교하였다. 실험 결과, Direct Answer의 정확도는 약 16%였던 반면 CoT의 정확도는 약 88%로 나타나, CoT 적용 시 약 72%p의 큰 성능 향상이 확인되었다. 이는 다단계 계산과 추론이 필요한 수학 문제에서 중간 추론 과정을 명시적으로 생성하는 것이 정답 도출에 효과적임을 보여준다.
반면 CoT는 Direct Answer보다 평균 출력 토큰 수와 생성 시간이 크게 증가하였다. Direct Answer는 매우 적은 토큰과 짧은 시간으로 응답한 반면, CoT는 평균 약 270개 이상의 출력 토큰과 약 5초 이상의 생성 시간을 사용하였다. 따라서 CoT는 수학 추론 정확도를 크게 높일 수 있지만, 그 대가로 추론 비용과 응답 시간이 증가한다는 점을 확인하였다.
이러한 결과는 CoT가 특히 수학적·기호적 추론 과제에서 효과적이라는 원 논문의 주장과 방향적으로 일치한다. 다만 본 실험은 하나의 모델과 GSM8K 일부 표본만을 대상으로 수행한 축소 재현이므로, 지식 및 상식 과제에서도 CoT의 성능 향상은 작고 비용만 증가하는지를 확인하기 위해서는 추가 데이터셋 실험이 필요하기 때문에 추후에 knowladge 영역에서의 실험도 재현할 예정이다.